CRM enrichment per il cross sell bancario: due score di propensione per una banca del credito al consumo

Una banca del credito al consumo, che sta ampliando l'offerta ai prodotti bancari retail, aveva circa mezzo milione di clienti già in relazione con la banca ma un CRM che descriveva il finanziamento in essere, non la persona. Le campagne di cross sell partivano al buio: conversioni basse, costi di contatto alti, clienti infastiditi da proposte fuori bersaglio. Con il CRM enrichment sul modello analitico Replica il team Marketing e CRM lavora oggi su attributi probabilistici sintetizzati in sei indici e due score di propensione con tier operativi: la base per decidere chi contattare, con quale prodotto e in che ordine.

La sfida

Il CRM descrive il finanziamento in essere, non la persona. Le campagne su conto, carta e prestiti raggiungono tutti allo stesso modo: pochi convertono, molti si sentono spammati, il budget si disperde.

La soluzione

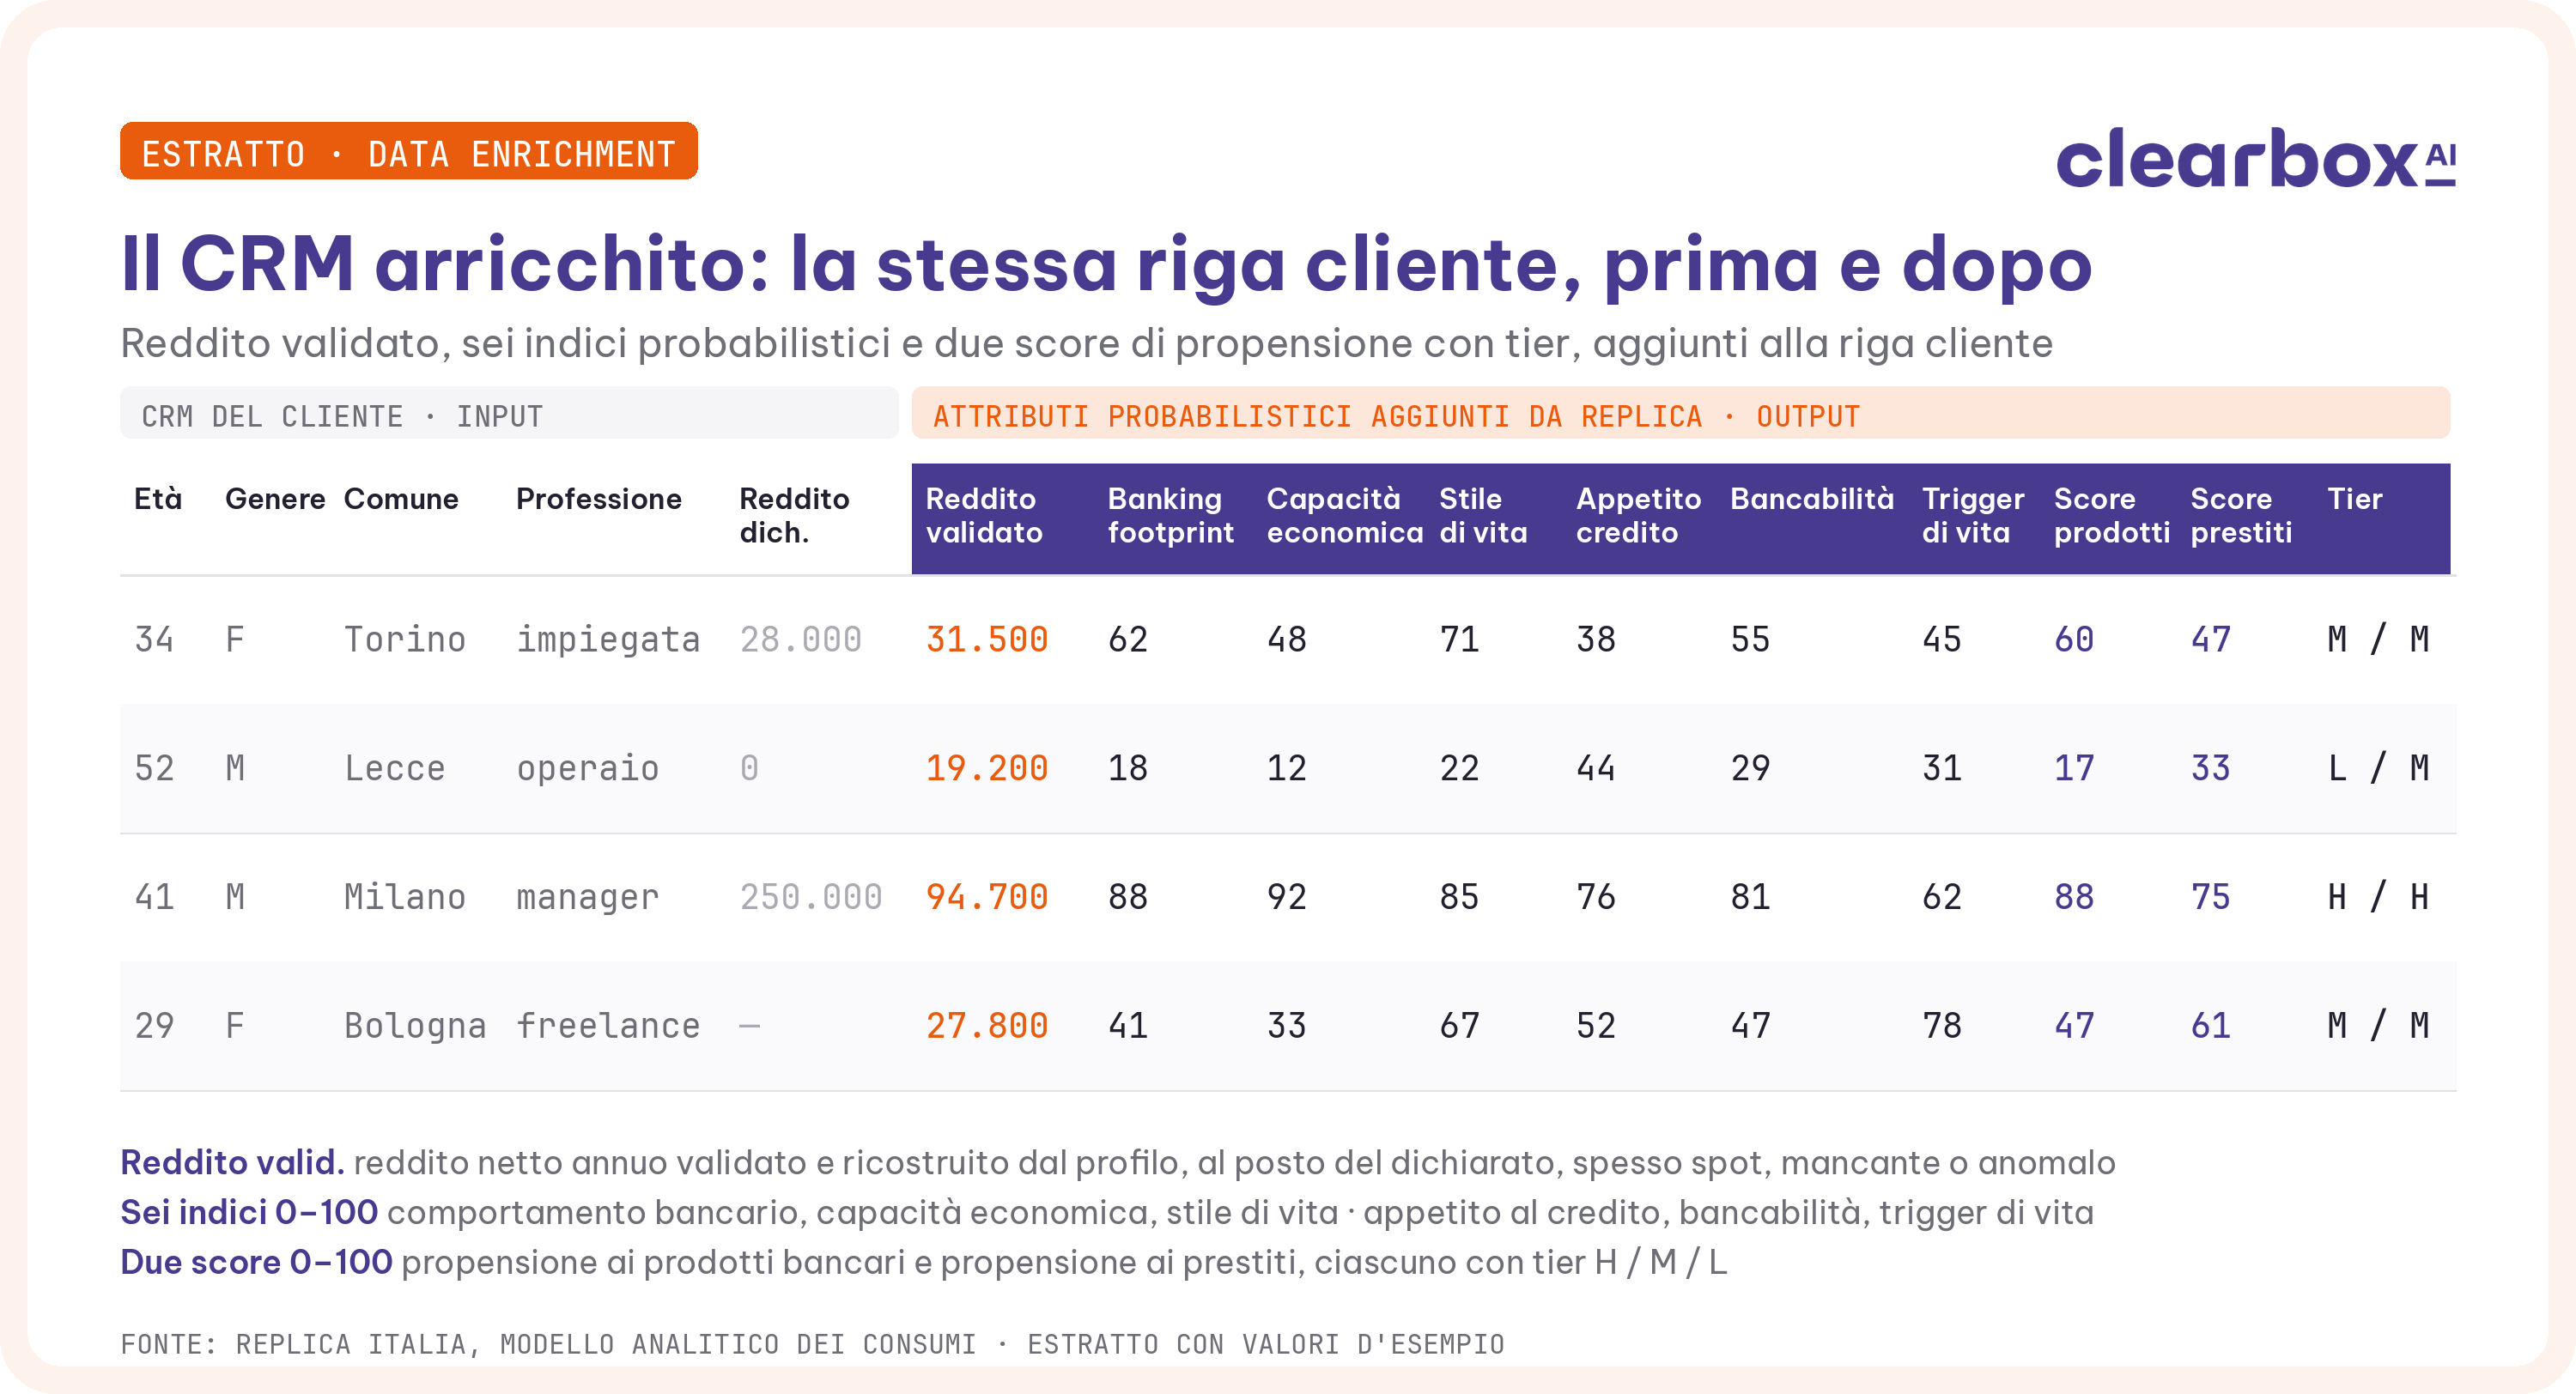
Bridge del CRM sul modello analitico Replica, lavorando solo su dati anonimi negli ambienti della banca; attributi probabilistici sintetizzati in sei indici e due score 0–100 (propensione ai prodotti bancari, propensione ai prestiti) con tier High / Medium / Low, validati e aggiornati ogni mese. In più un reddito validato al posto del dichiarato.

Il risultato

Base clienti segmentata in tier 30 / 45 / 25 e quattro profili tipo che diventano azioni commerciali: il prodotto giusto ai clienti propensi, contatti concentrati dove convertono, nessuna pressione su chi non è interessato.

Il pain: cross sell senza segnali

L'interlocutore era il team Marketing Intelligence e CRM della banca. L'obiettivo era concreto: trasformare una base acquisita tramite il credito al consumo in clienti bancari a tutto tondo, proponendo conto, carta e prestito personale a chi è davvero ricettivo. Il problema era altrettanto concreto: il CRM conteneva i dati necessari a gestire il rapporto in essere, ma nulla che descrivesse la persona oltre il finanziamento. Nessuna vista su come il cliente spende, se e quanto usa altri strumenti bancari, quale capacità economica ha davvero, se un evento di vita sta per generare un nuovo bisogno. Il reddito disponibile era quello dichiarato una volta sola all'apertura del rapporto, mai aggiornato: un attributo che il team non usava per segmentare perché non si fidava. Il risultato erano campagne indistinte, con tassi di conversione bassi, costi di contatto elevati e un effetto collaterale che il team temeva più di tutti: clienti buoni infastiditi da proposte sbagliate, e quindi meno disponibili la volta dopo.

Il perimetro è stato definito in un kick off congiunto: due propensioni da misurare, ai prodotti bancari e ai prestiti aggiuntivi; un output leggibile dal team CRM senza modelli intermedi, cioè pochi indici e score già pronti per segmentare; un'impostazione privacy by design, concordata con le funzioni competenti della banca, in cui è il modello analitico Replica a muoversi verso gli ambienti del cliente e non il contrario. L'arricchimento lavora esclusivamente su dati anonimi e nessun dato personale lascia la banca. Il dataset arricchito e un report di validazione sono stati discussi insieme in un incontro di restituzione con il team.


Come funziona l'arricchimento

Il meccanismo non richiede di conoscere il cliente: richiede di conoscere chi gli somiglia. Ogni riga del CRM viene associata, tramite le sole chiavi anonime disponibili a valle dell'anonimizzazione, alla cella corrispondente del modello analitico dei consumi Replica, costruito su dati transazionali multi fonte, dati geo, open data e statistiche ufficiali. Dalla cella il cliente eredita attributi probabilistici su tre dimensioni: comportamento finanziario (rapporti bancari, carte di pagamento elettroniche, spesa mensile, adozione del BNPL), capacità economica (reddito familiare, valore immobiliare della zona, indebitamento) e contesto di vita (stile di consumo, digitalizzazione, fase di vita, densità di banche e concessionari nell'area di residenza). Sono attributi probabilistici: descrivono quanto è verosimile un comportamento per un profilo, non un fatto osservato sulla singola persona.

Clearbox sintetizza queste dimensioni in sei indici 0–100 con pesi espliciti e concordati, tre per ogni propensione, e li combina in due score. Il primo misura la ricettività a conto, carta e investimenti: pesa soprattutto il comportamento bancario osservato nella cella, poi lo stile di vita e la capacità economica. Il secondo misura la propensione a un finanziamento aggiuntivo rispetto a quello in essere, letta come tre domande indipendenti: il cliente accetta il debito come strumento (appetito al credito), può sostenerlo (bancabilità residua), ha un motivo imminente per chiederlo (trigger di vita su auto, casa, famiglia). Ogni score genera un tier High / Medium / Low con soglie fisse sulla distribuzione, così che i tier siano stabili di mese in mese.

Nello stesso passaggio il reddito dichiarato viene validato e ricostruito dal profilo. È un pain point comune a quasi tutte le banche: il reddito autodichiarato è spot, mai aggiornato, spesso mancante o anomalo, e nel caso in esame la correlazione tra dichiarato e ricostruito era 0,26, di fatto due grandezze scollegate. Il reddito validato sostituisce il dichiarato nelle analisi e diventa l'input della capacità economica: un plus dell'arricchimento che rende finalmente utilizzabile un attributo che oggi resta nel cassetto.


Dagli score alle campagne, ogni mese

Il team CRM ritrova nel proprio ambiente la base clienti con poche colonne in più: reddito validato, sei indici, due score e i relativi tier. Sono colonne pensate per essere usate subito, con filtri e segmenti nel CRM, senza passare da un modello. Le feature di dettaglio da cui gli indici derivano restano disponibili per il team Data Science della banca, per chi vuole costruire modelli propri o ricalibrare i pesi, ma non servono per agire.

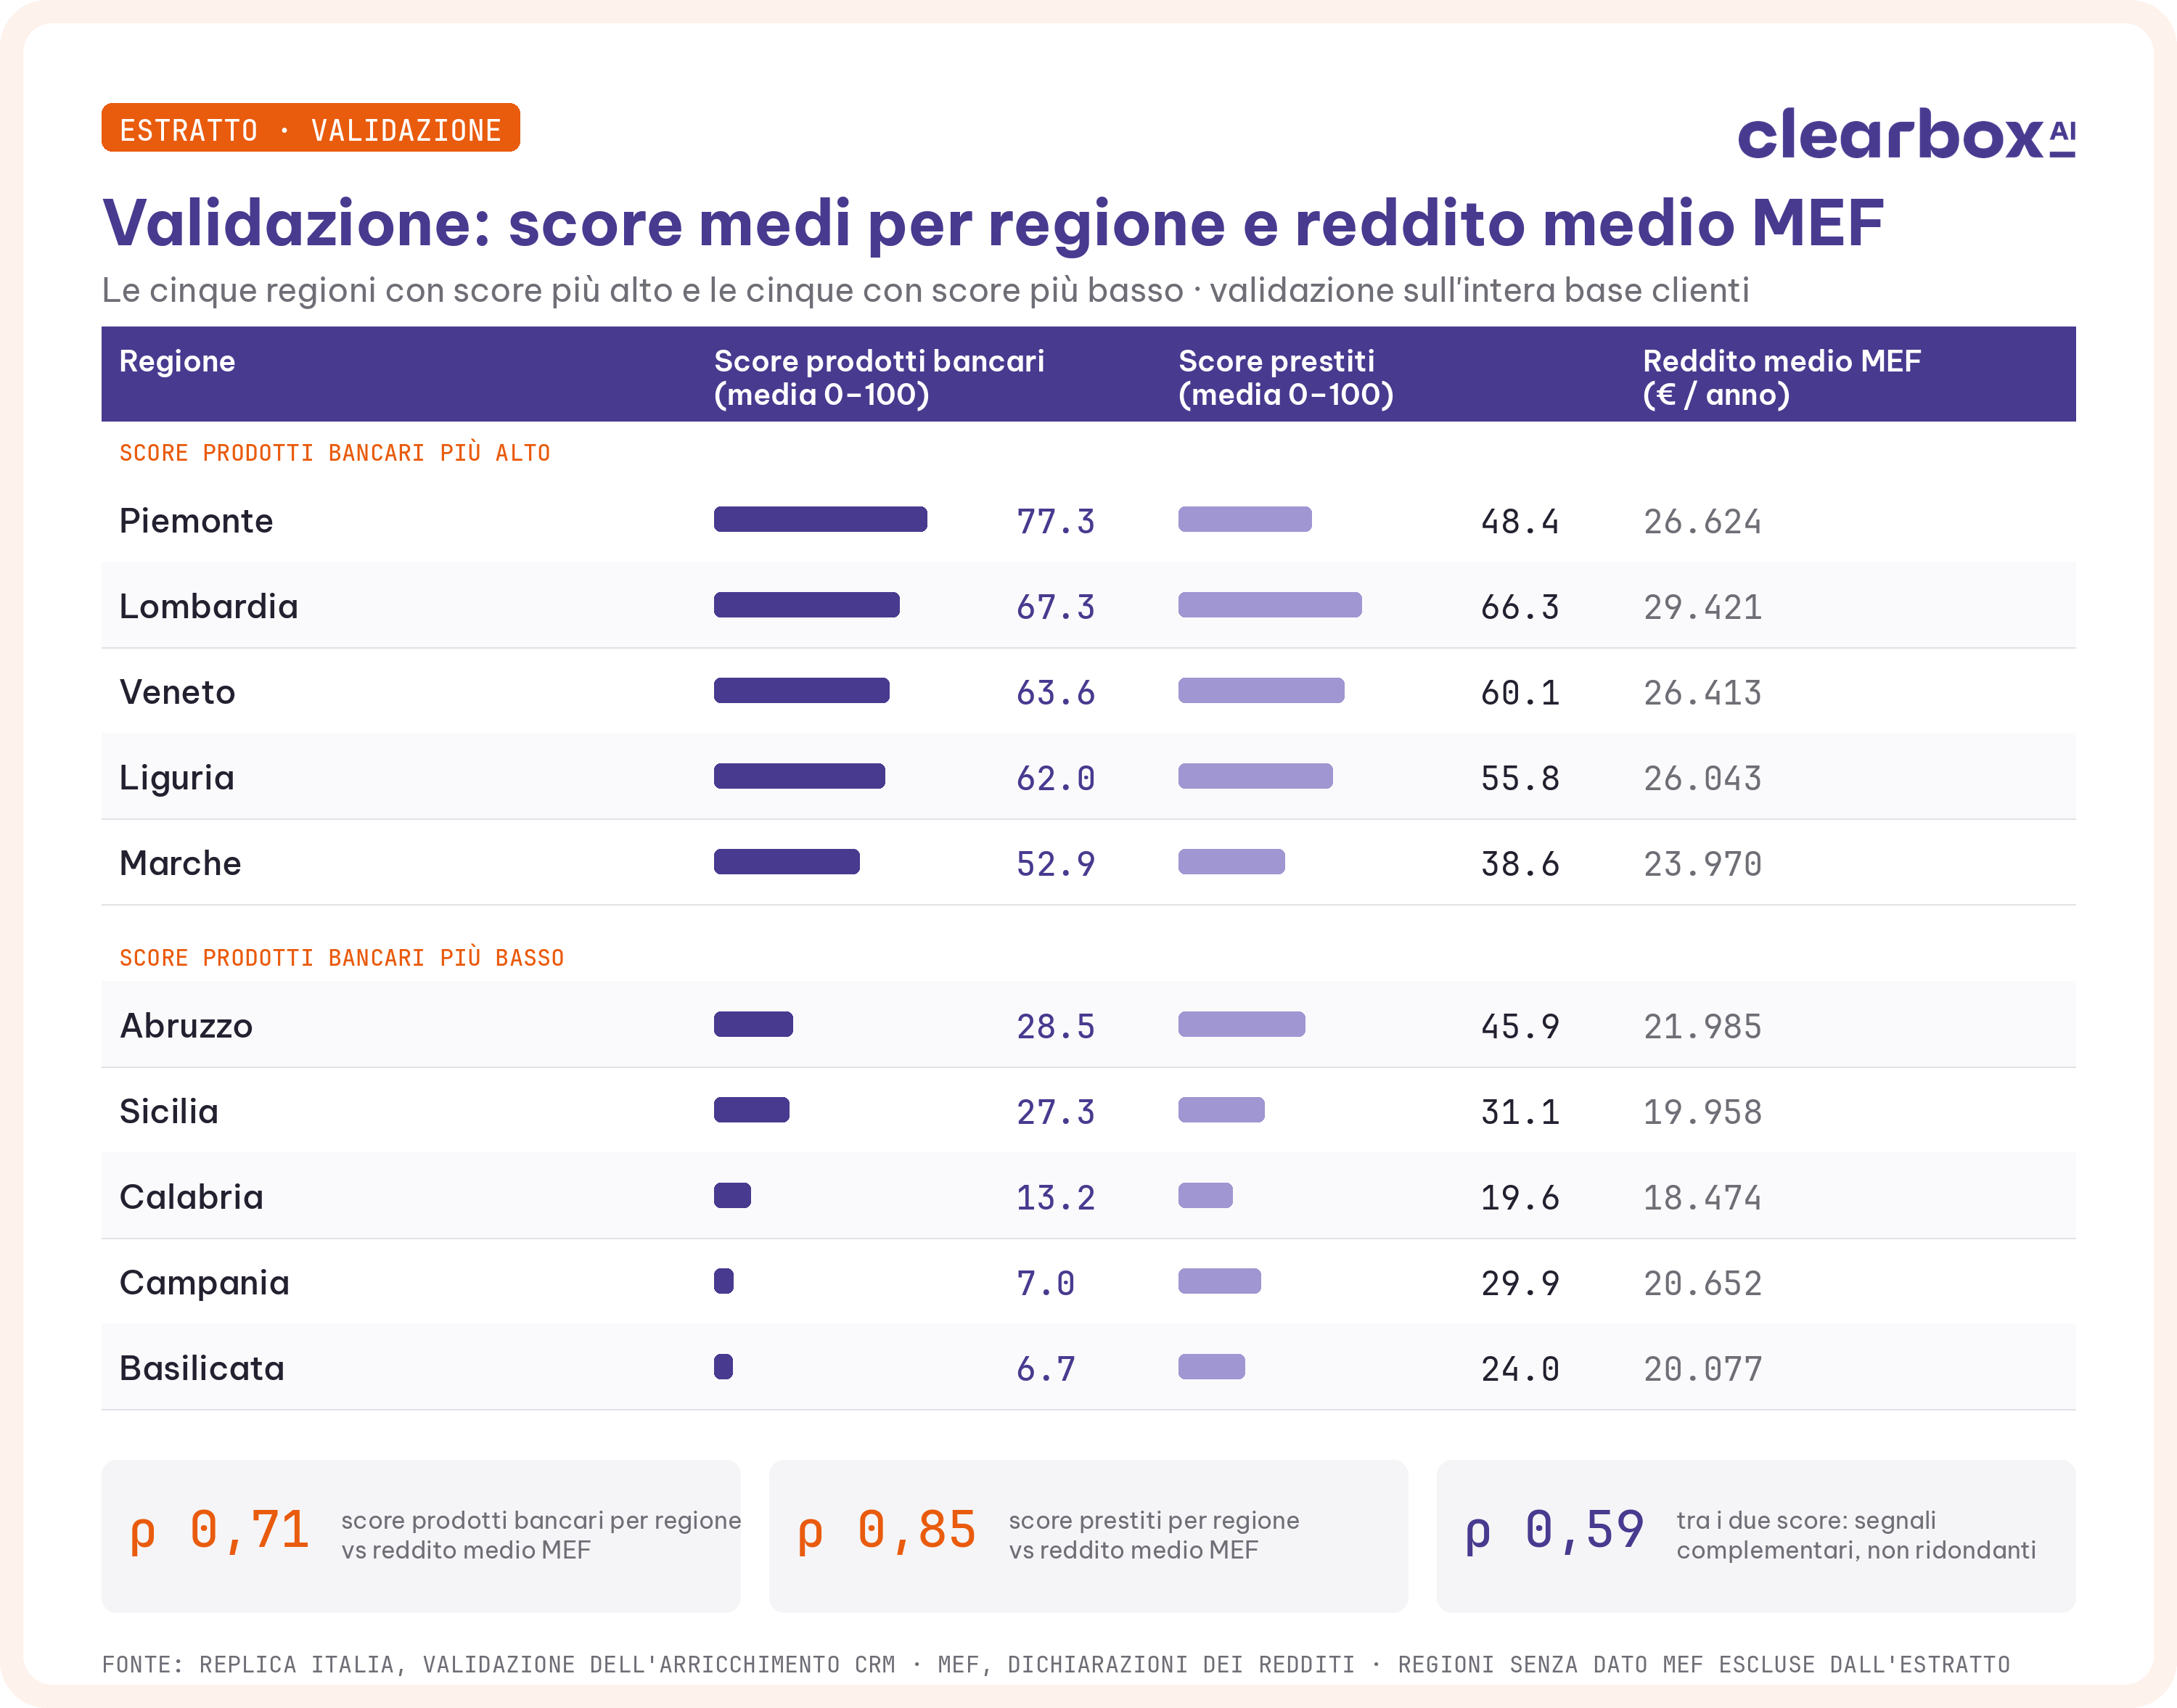
Prima della consegna gli score sono validati sull'intera base con controlli che il team può rileggere: distribuzione dei tier 30 / 45 / 25 rispettata su entrambi gli score, code nette tra Low e High senza sovrapposizioni, curva per età coerente con le attese (la propensione ai prestiti ha il picco tra 40 e 59 anni, quella ai prodotti bancari un profilo più piatto con cali agli estremi), ranking regionale allineato al reddito medio MEF (ρ 0,71 per i prodotti bancari, 0,85 per i prestiti) e due score parzialmente indipendenti tra loro (ρ 0,59), quindi complementari e non ridondanti. I decili estremi non sono una semplice riproduzione del reddito: il top decile dello score bancario è fatto di lavoratori dipendenti con mutuo e più rapporti bancari, il bottom decile di pensionati con un solo rapporto.

Da lì il team costruisce quattro profili operativi che diventano regole di campagna. Score bancario alto e score prestiti medio: conto remunerato e carta, cross sell prioritario. Entrambi gli score alti: cliente premium, conto deposito e prestito personale con contatto dedicato. Score prestiti alto con trigger di vita: candidato a prestito personale, con timing legato all'evento. Entrambi gli score bassi: nessuna offerta push, relazione di base e costo di contatto minimo. Il servizio è continuativo: refresh mensile sui nuovi clienti e sull'evoluzione del modello Replica, nuovi indici aggiungibili nel tempo secondo le esigenze di marketing e banca, e ricalibrazione dei pesi con gli esiti reali delle campagne, per passare da un buon ordinamento della base a una discriminazione fine anche dentro ogni tier.


Parla con noi

Vuoi vedere Replica all'opera sui tuoi temi o ricevere un campione di dati? Compila il form e il nostro team ti ricontatterà rapidamente.

Copyright 2026 Clearbox AI All rights reserved | Code of Conduct | Privacy Policy